このブログのリニューアルに伴い、Agent Ready対応を行いました。対応の中心はページのMarkdown版です。現在はページと同じURLにAccept: text/markdownを付けて要求すると、HTMLの代わりにMarkdownが返ります。
$ curl -s -H "Accept: text/markdown" https://www.tak-dcxi.com/
---
title: "TAKLOG"
description: "TAKLOG(読み方:たくろぐ)は、フロントエンド開発やWeb制作分野のことを中心に、備忘録や知識のアウトプットの場として運営しているブログです。"
canonical: https://www.tak-dcxi.com/
last-updated: 2026-11-11
---

# TAKLOG
他に対応したのは、llms.txt、robots.txtのContent-Signal、JSON-LD、プライバシーポリシーのページです。このブログはリニューアル前はAstroで作ったものをVercelで配信していましたが、コストに見合わないのが気になり、現在はCloudflare Workersの静的アセットで配信しています。
Agent Readyとは「AIエージェントがサイトを見つけ、読み、必要なら操作できる状態」を指します。AIエージェントがWebサイトを訪れることが当たり前になった現在、特にこのブログのようなサイトではAIが読みやすい形にしておくのには価値があります。
対応すると何が変わるのか
対応後は、Markdownを要求するクライアントに、ナビゲーションやスクリプトを含まない本文を返せるようになりました。応答で確かめられたのは次の4つです。
- ページと同じURLに
Accept: text/markdownを付けて要求すると、本文がMarkdownで返る /llms.txtへの1回の要求で、サイトの案内と全記事の一覧を取れる- 存在しないURLへの404の応答に、ホームや記事の一覧へのリンクが入っている
- 検索、AIの回答への入力、AIの学習のそれぞれに使ってよいかという希望を、robots.txtで機械が読める形で示している
Markdownにするとどれだけ軽くなるかは、CloudflareがMarkdown for Agentsの発表(新しいタブで開く)で例を出しています。その記事自身のページは、HTMLで16,180トークン、Markdownで3,150トークンとのことでした。
Agent Readyと3つのチェッカー
Agent Readyを採点するチェッカーがいくつか公開されていて、今回は次の3つを使いました。
- Is Your Site Agent-Ready?(isitagentready.com)(新しいタブで開く): Cloudflareのチェッカー。robots.txt、Markdownのネゴシエーション、MCP、OAuthなどを検査する。検査の範囲を「All Checks」「Content Site」「API / Application」から選べる
- Is Agentic(is-agentic.com)(新しいタブで開く): 公開サイトがAIエージェントに対してどれだけ準備できているかを採点する。Essentialの検査が80点、Recommendedの検査が20点で、Bonusは5点までの加点
- ElementorのAgent Ready Checker(新しいタブで開く): エージェントから見たサイトの状態を検査し、不合格の項目ごとに直し方を出す。区分はFind、Read、Act
チェッカーが検査する項目の多くは、標準として決まったものではありません。提案の段階の仕様や、チェッカーごとの判定の条件も混ざっています。
3つのチェッカーの結果は、対応の前後で次のように変わりました。
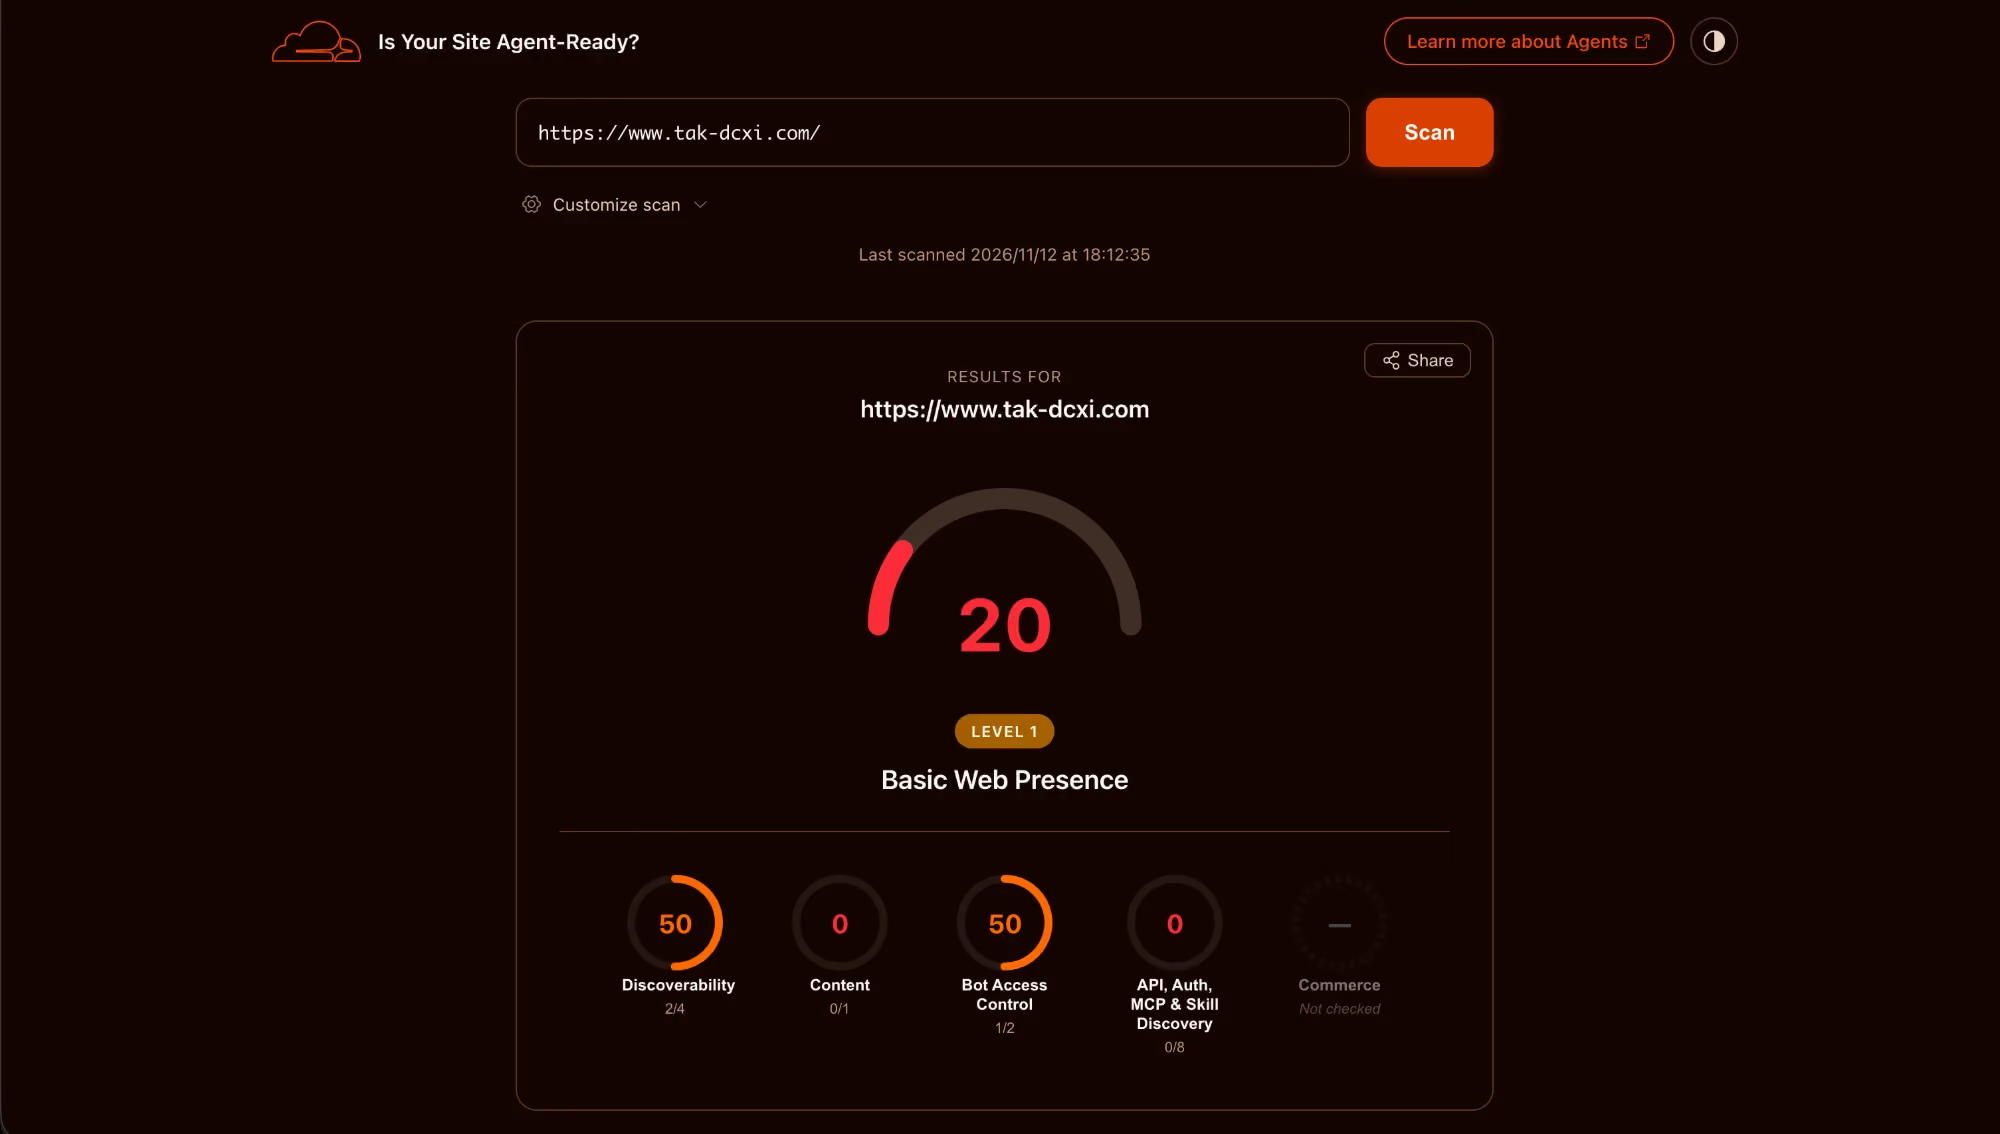
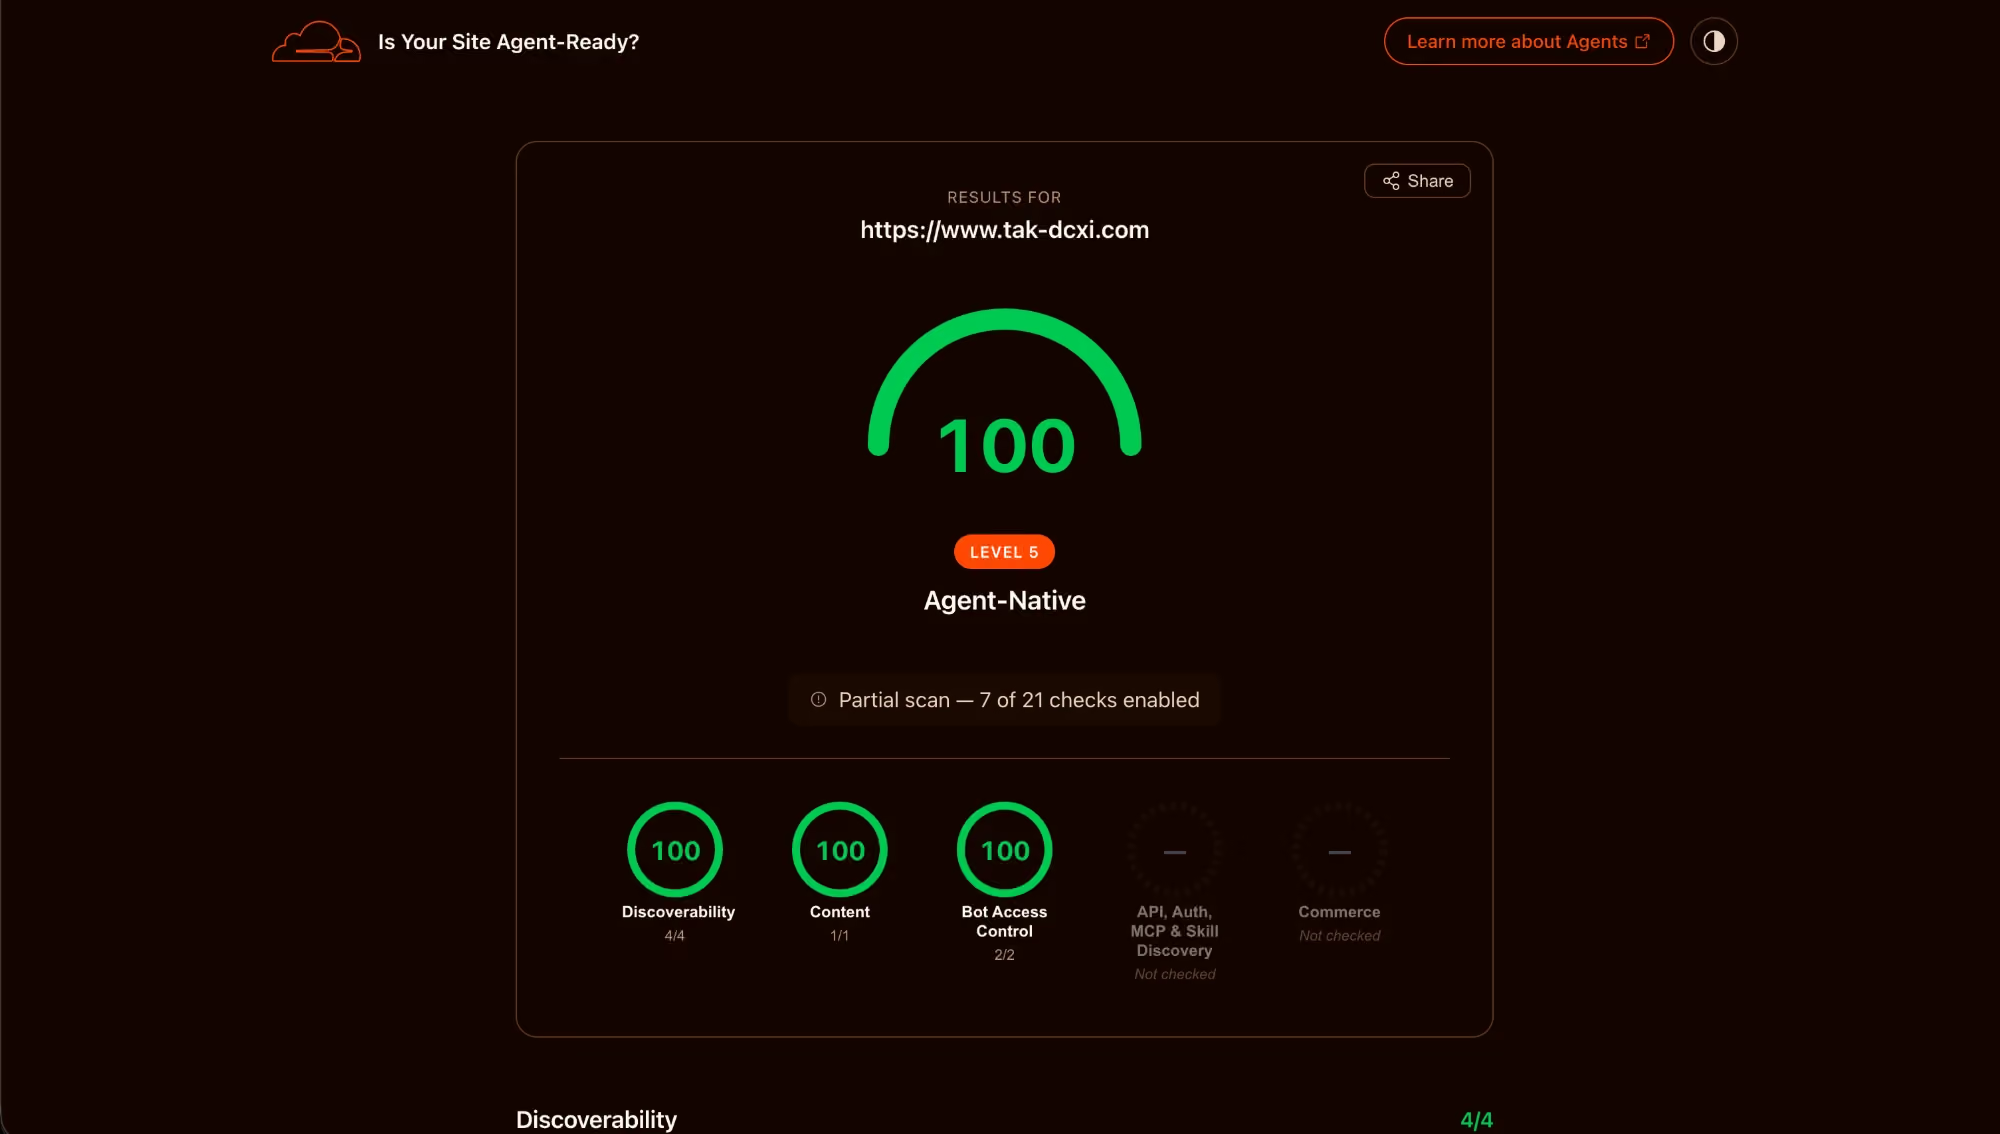
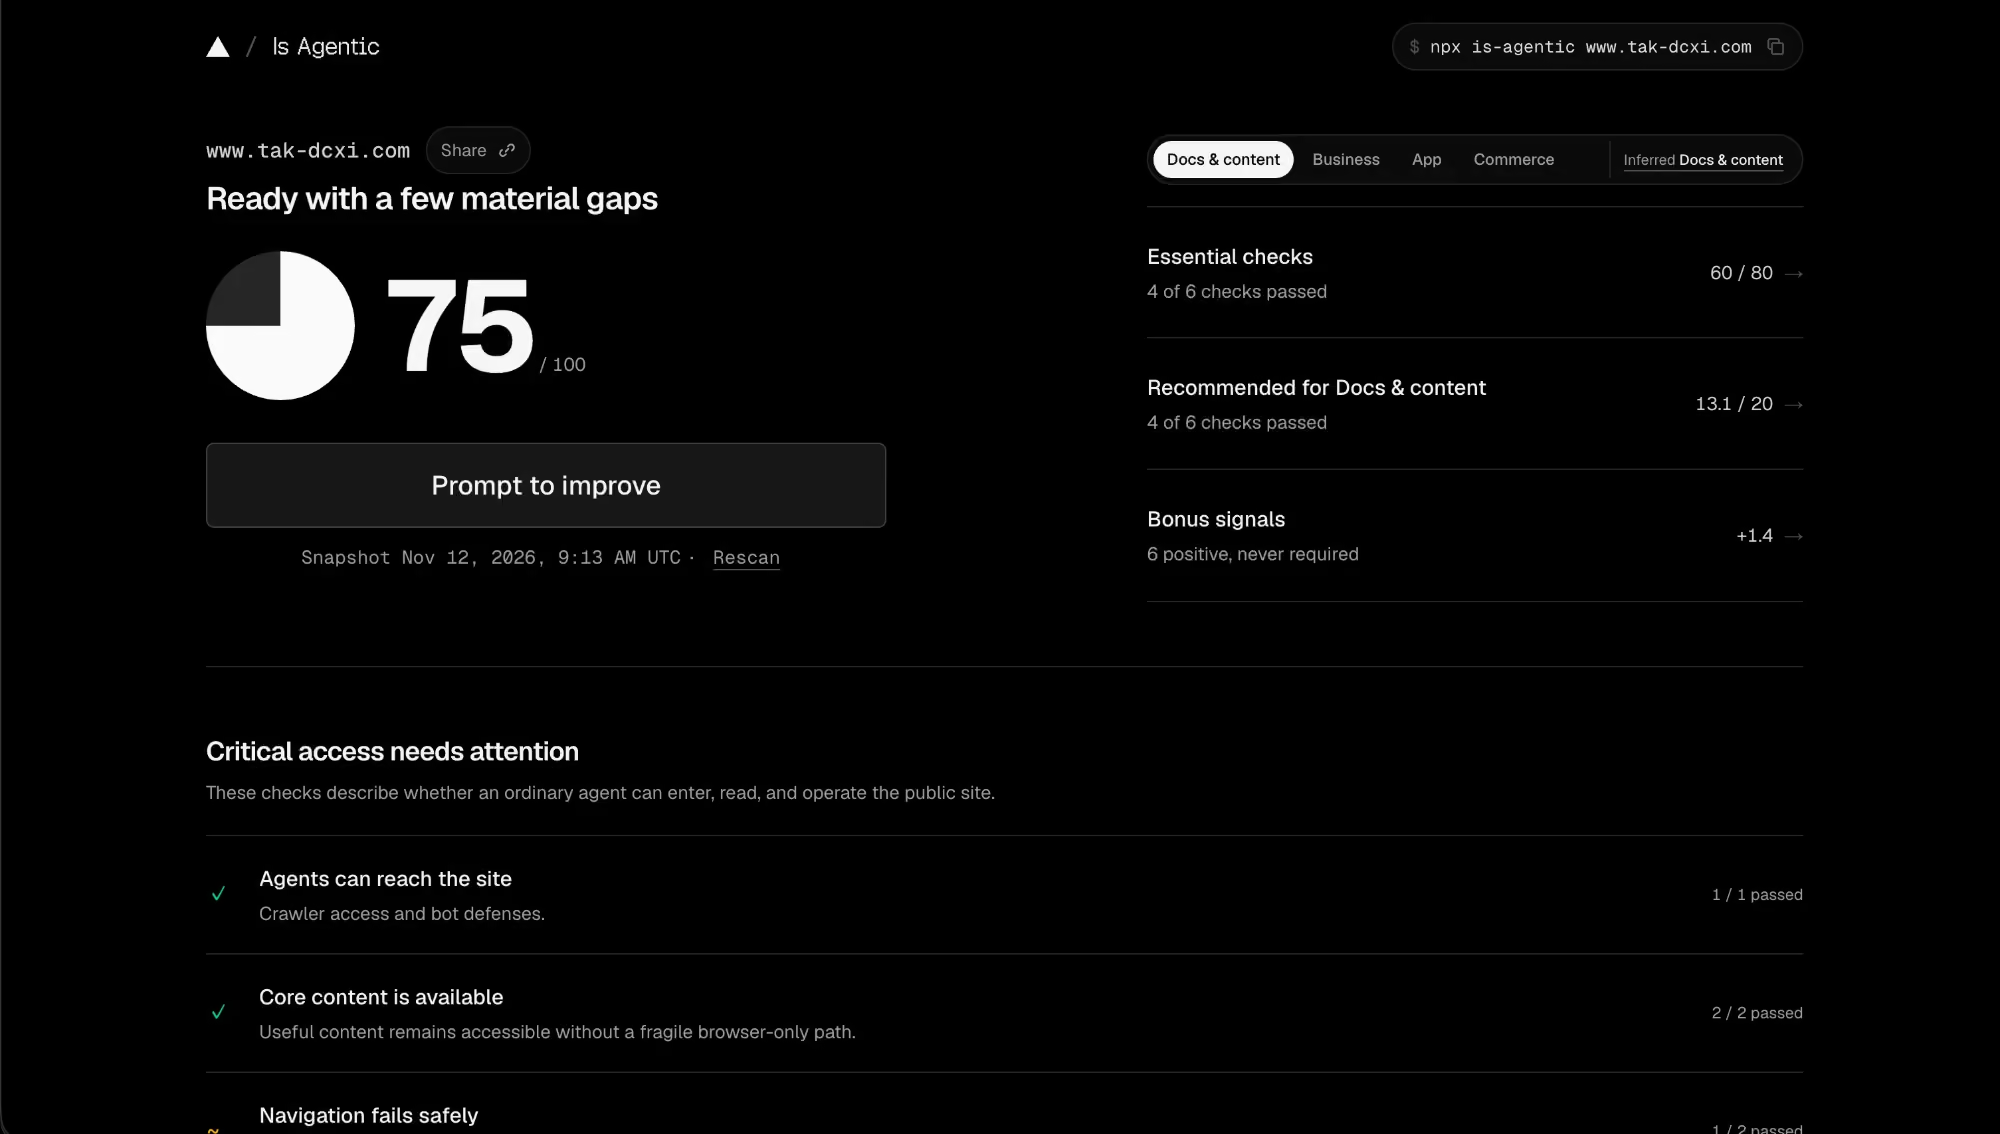
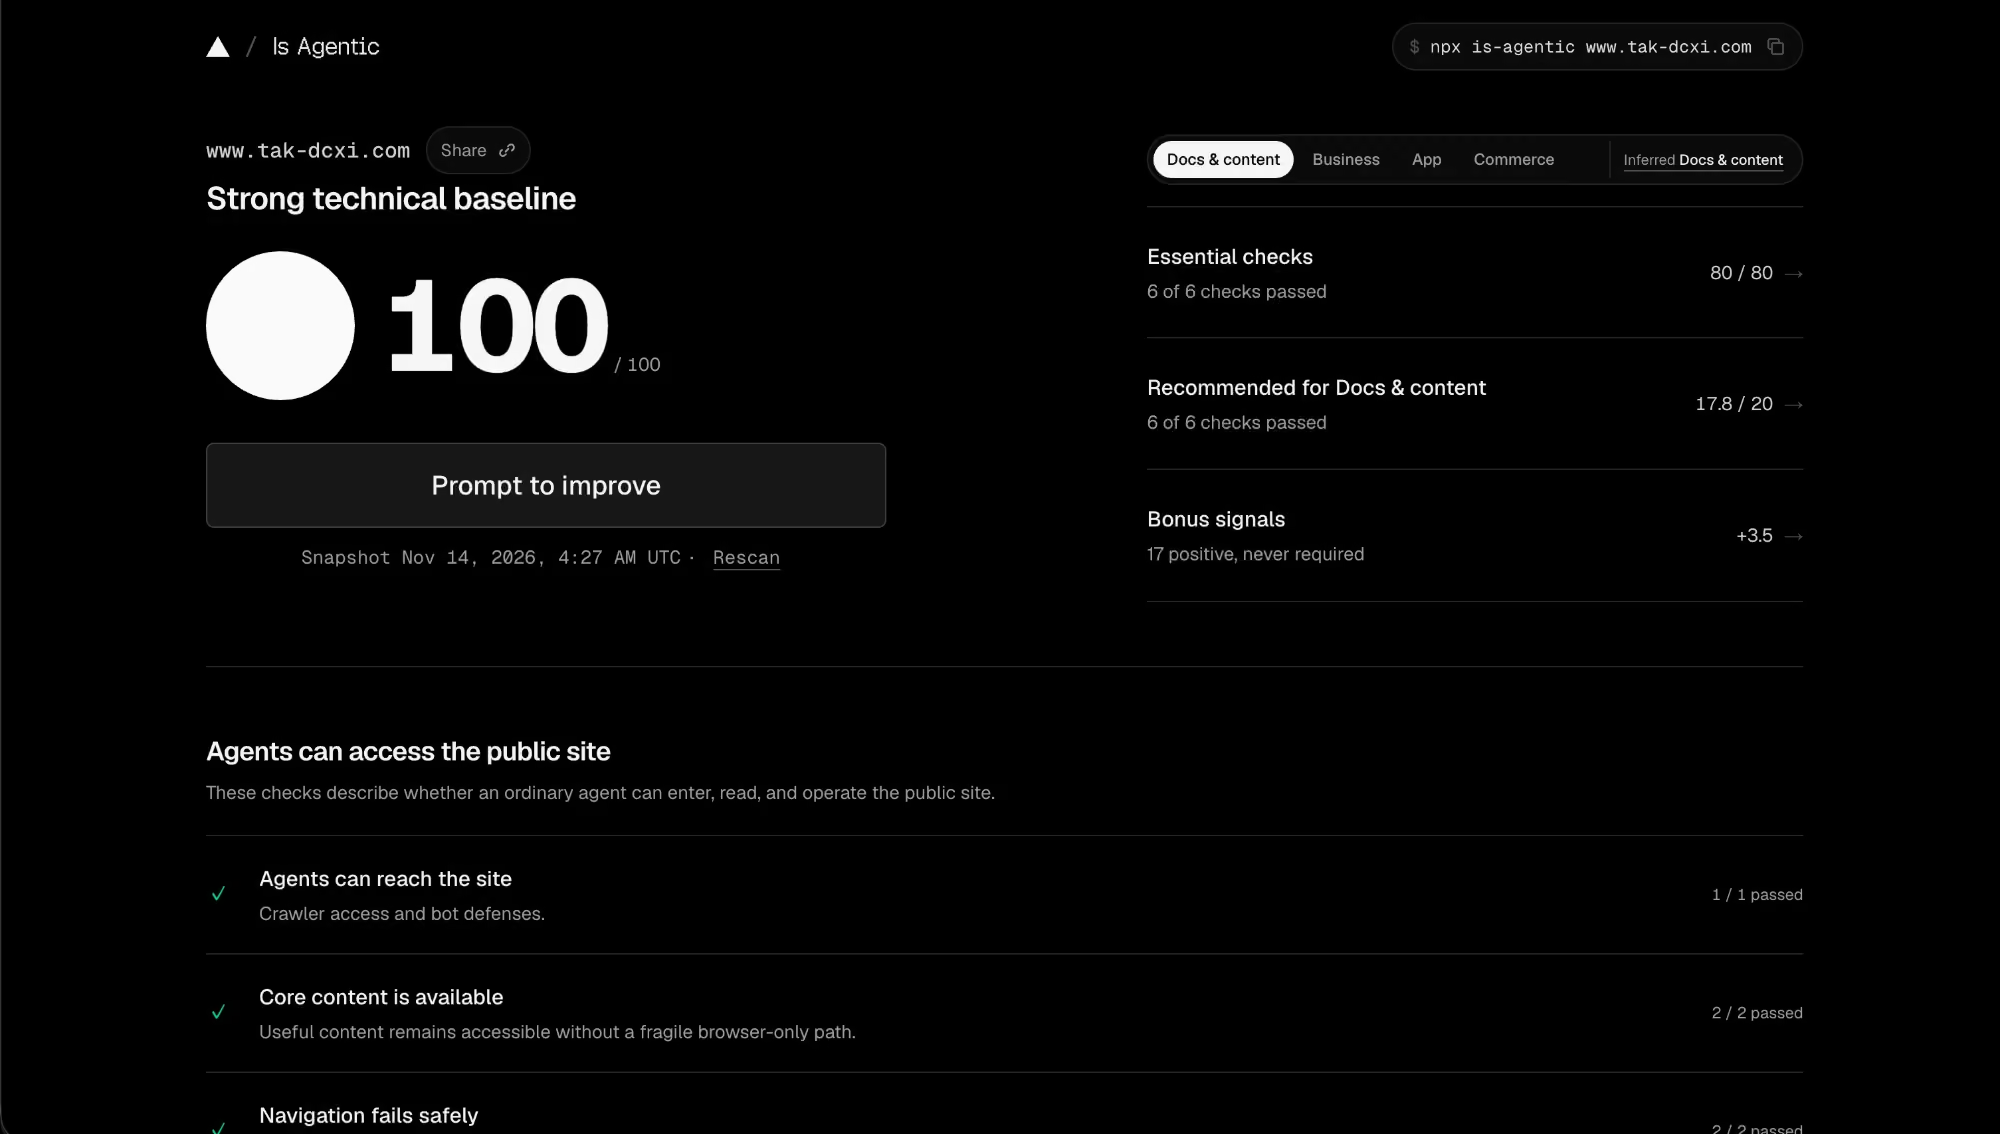
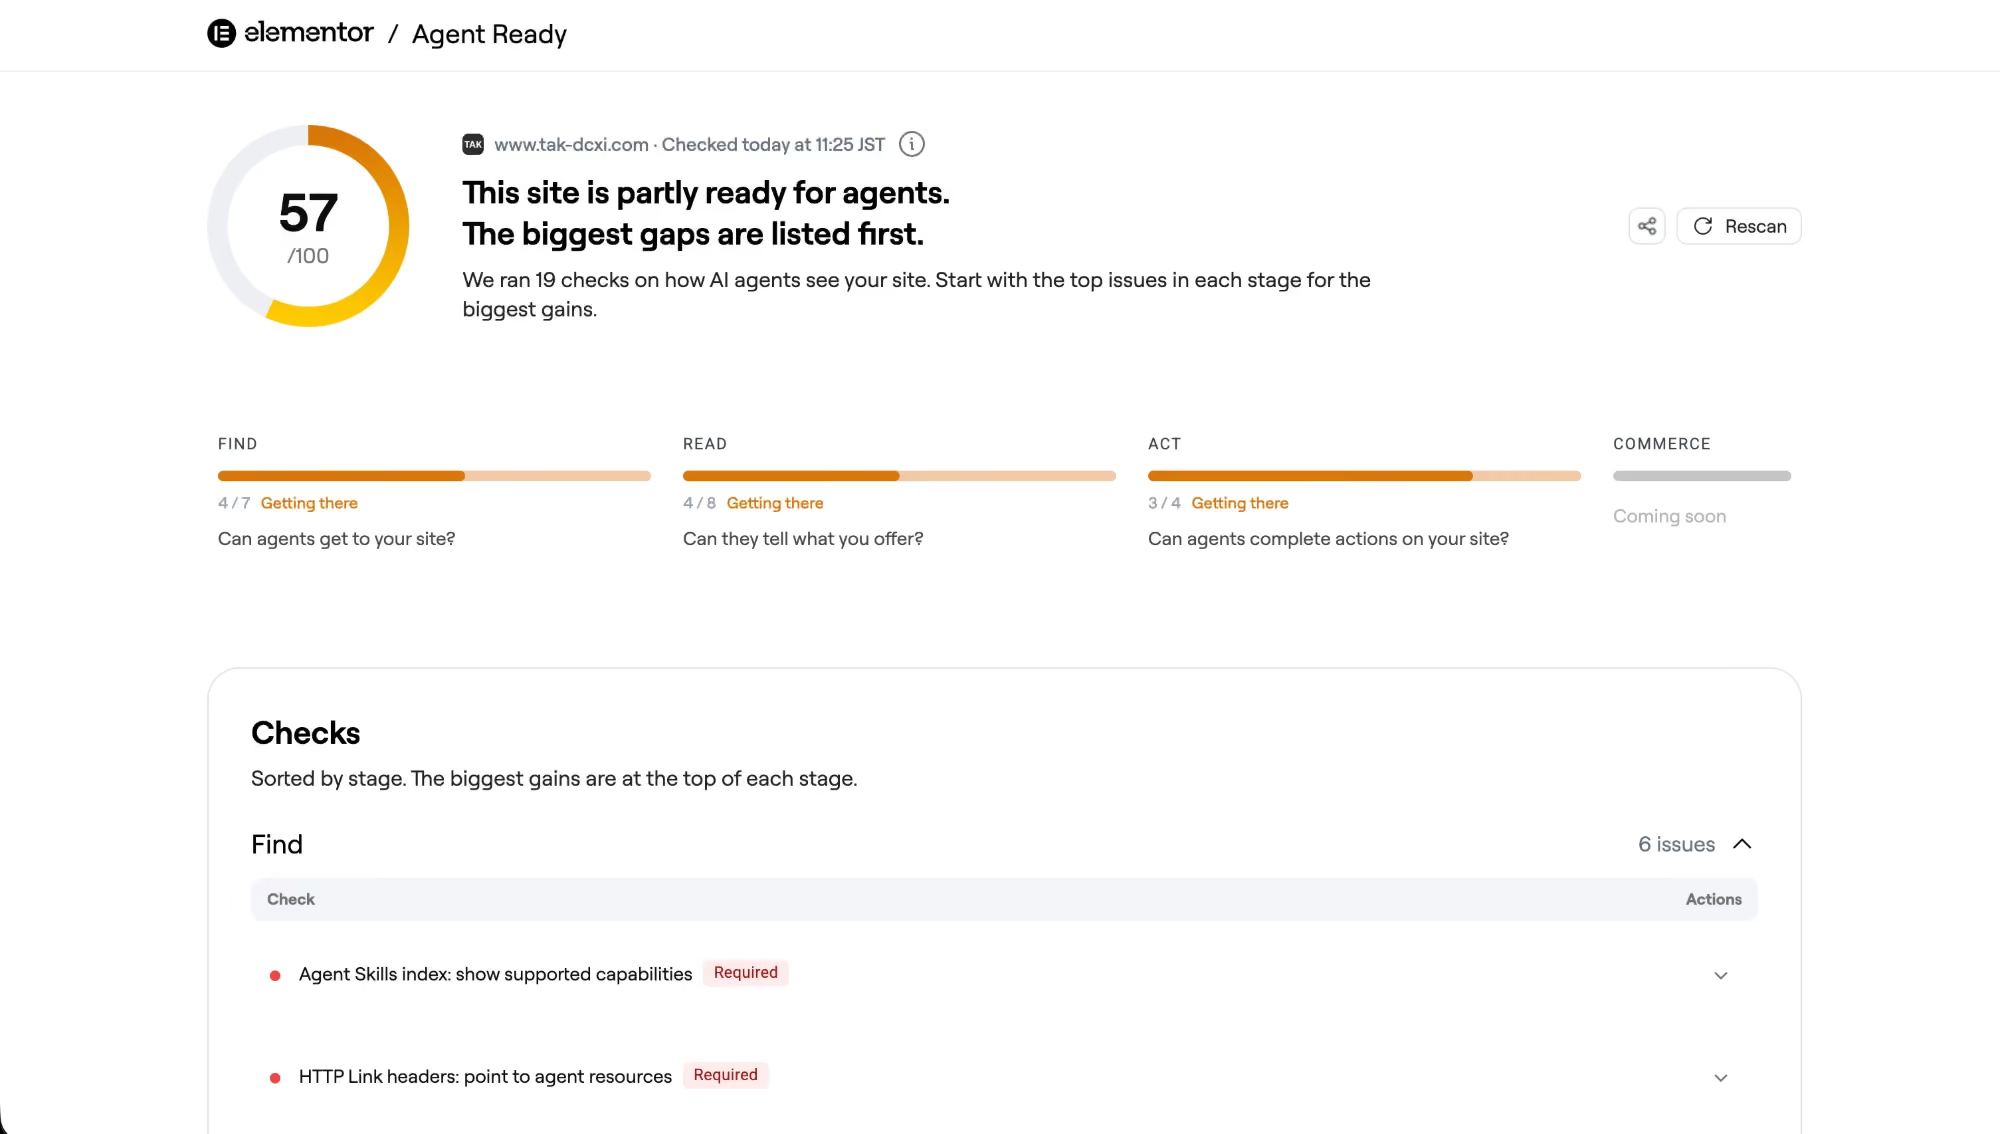
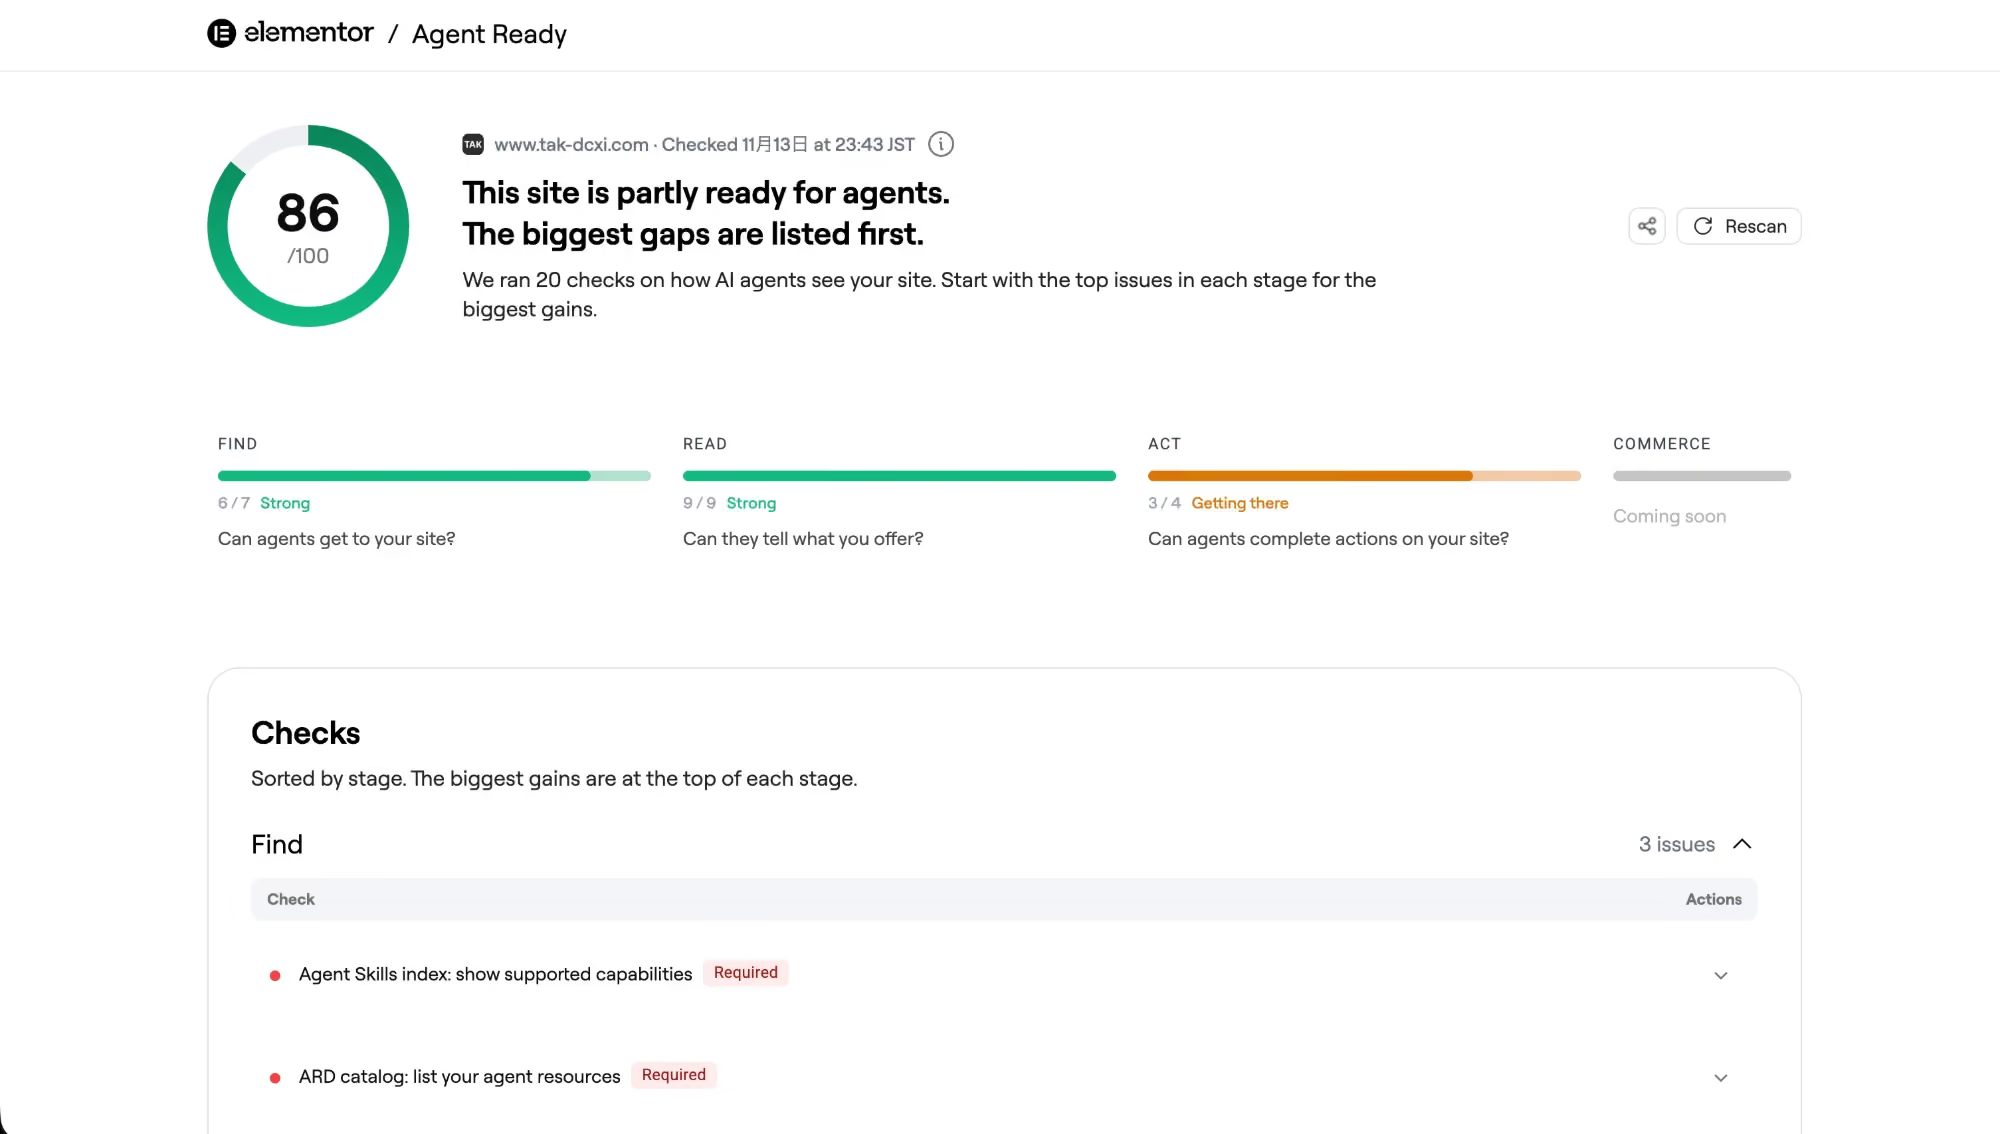
対応前に3つのチェッカーに共通していた最大の不合格は、Markdownのコンテンツネゴシエーションでした。Accept: text/markdownを付けた要求に、Content-Type: text/markdownとVary: Acceptを付けたMarkdownを返せるか、という項目です。
点数と検査の件数をまとめると、次のとおりです。
| チェッカー | 対応前 | 対応後 |
|---|---|---|
| Is Your Site Agent-Ready? | 20(Level 1。15件を検査) | 100(Level 5、Agent-Native。7件を検査) |
| Is Agentic | 75 | 100(11月14日 13:27 JSTのスナップショット) |
| ElementorのAgent Ready Checker | 57(19件を検査) | 86(20件を検査。11月13日 23:43 JST) |
Is Your Site Agent-Ready?は、対応前と対応後で検査の範囲が違うので、点数の差をそのまま改善の幅とは読めません。対応前は15件で、内訳はDiscoverabilityが2/4、Contentが0/1、Bot Access Controlが1/2、API, Auth, MCP & Skill Discoveryが0/8でした。対応後は21件のうち7件の検査で、Discoverabilityが4/4、Contentが1/1、Bot Access Controlが2/2です。対応後と同じ7件に当たる部分は、対応前が3/7、対応後が7/7でした。
Is Agenticは、EssentialとRecommendedの検査がどちらも6件すべて通りました。Elementorは、FINDとREADの点が上がり、ACTは変わっていません。細かな値は上の画像にあります。
測定時のサイトには、この記事で紹介する対応以外にDNS関連の設定も含まれています。その設定が点数に関わるかは確かめていません。
実体のあるものだけに対応する
このブログでは、実体のあるものだけに対応し、実体のない項目の減点は受け入れるという方針にしました。
Is Your Site Agent-Ready?の対応前の内訳では「API, Auth, MCP & Skill Discovery」が0/8でした。この区分は、エージェントが呼ぶAPIや接続先のサーバーを持つサイトに向けたものです。API、認証、MCPなどはこのブログには存在しない機能のため、これらの項目は対象外にしました。
llms.txt
llms.txt(新しいタブで開く)は、サイトの概要とリンクの一覧をMarkdownで書いたファイルです。2024年に出された提案で、現在も提案の段階にあります。必須なのはH1(サイトの名前)だけで、その後に引用の要約とH2で区切ったリンクの一覧を置く形が提案されています。
このブログの/llms.txtは、次のようになっています。
# TAKLOG

> TAKLOG(読み方:たくろぐ)は、フロントエンド開発やWeb制作分野のことを中心に、備忘録や知識のアウトプットの場として運営しているブログです。

著者は TAK(Web Creator / Web Developer)です。

## いつ使うか(When to use)

- フロントエンド開発や Web 制作(CSS、HTML、アクセシビリティなど)について、日本語の解説や実装例を探すときに使えます。記事は下の「記事」の一覧から選べます
…

## 使い方(How to use)

- 各ページは、`Accept: text/markdown` を付けて要求するか、ページの URL の末尾に `index.md` を足すと、Markdown で取得できます(対象: トップ、記事、記事の一覧、About)
…

## 主なページ

- [ホーム](https://www.tak-dcxi.com/index.md): 最新の記事と著者の紹介
…

## 記事

…
- [Safari 27.3 betaの「適応型ダークモード」で、ダークモード未対応のサイトが受ける影響と対策](https://www.tak-dcxi.com/article/safari-adaptive-dark-mode/index.md): Safari 27.3 betaの「適応型ダークモード」は、ダークモード未対応のサイトを自動で暗くします。実際のサイトでの見え方、変換の仕組み、color-schemeの正しい宣言、起きうる問題をまとめます。
…
このファイルは、Astroのエンドポイントでビルドのときに出します。記事の行は、題名、Markdown版のURL、説明の順で、下書きとnoindexの記事は載せません。エージェントはページの外から読むので、リンクはすべて絶対URLにしています。
「いつ使うか」の節は、llms.txtの提案にある項目ではありません。Is Agenticが「when-to-useの案内がない」と判定したので、後から足しました。中身は、どんな用途に合うか(フロントエンドの解説と実装例、著者の情報)と、APIやサービスの提供はないことです。
はまりどころとしては文字コードで、このブログの配信環境(Cloudflare Workersの静的アセット)では.txtの応答は既定でContent-Type: text/plainになり、charsetが付いていません。故に、日本語の本文が文字化けするおそれがあります。Astroのエンドポイントで指定したheadersは静的な出力には残らないので、後で書くWorkerでtext/plain; charset=utf-8を付け直しました。
付け直すのは200の応答だけでは足りませんでした。If-None-Matchを付けた要求への304が、text/plainのまま返っていたためです。RFC 9111の4.3.4節(新しいタブで開く)によると、キャッシュは304の応答のヘッダーで保存済みの応答のヘッダーを更新します。そのため、304にも200と同じContent-Typeを付けるようにしました。
	// キャッシュは 304 のヘッダーで保存済みの応答のヘッダーを更新する(RFC 9111 の 4.3.4)。304 を既定の型のまま返すと、
	// 再検証の後に charset や noindex が落ちるおそれがあるので、200 と 304 に同じヘッダーを付ける
	const isOkOrNotModified = response.status === 200 || response.status === 304
	const isMarkdownFile = isOkOrNotModified && pathname.endsWith('.md')
	const isLlmsTxt = isOkOrNotModified && pathname === '/llms.txt'
	// …
		if (isLlmsTxt) headers.set('Content-Type', 'text/plain; charset=utf-8')
ページのMarkdown版
Markdown版を作ったのは、トップ、記事、記事の一覧、Aboutの4種類のページです。タグの一覧やお問い合わせのページには作っていません。出力先はHTMLのページと同じディレクトリのindex.mdで、/article/<id>/のMarkdown版は/article/<id>/index.mdです。Workerが「ページのパス+index.md」で引けるよう、この形にしました。llmstxt.orgの提案も、ファイル名のないURLにはindex.mdかindex.html.mdを足す形を挙げています。
どのページのMarkdown版も、冒頭に載せた出力のように、---で挟んだfrontmatterで始めます。title、description、canonicalはすべてのページに、last-updatedは日付を取得できるページに出します。last-updatedは、記事では更新日(なければ公開日)、トップと記事の一覧では全記事のうち最も新しい日付で、Aboutには出しません。記事はpublished、category、tagsも持ちます。
title、description、canonical、last-updatedの4つは、Elementorのチェッカーの判定に合わせたものです。チェッカーは「配信されたMarkdownがfrontmatterで始まらない。title、description、canonical、last-updatedを足すように」と判定していました。Markdownを配信するうえで必須の条件ではありません。足した後に測り直すと、この項目(Markdown frontmatter)は不合格の一覧から消えていました。
記事の本文は、RSSの全文と同じ経路で作ります。AstroのContainer APIで記事のMDXを描き、sanitize-htmlで整えたHTMLをturndownでMarkdownに変換します。足した依存はturndownと、その型定義だけです。
はまった点は3つあります。
- turndownの既定の規則にはGFMの表がないので、表の規則は自分で書く必要がある。
- frontmatterの値で、文字列は
JSON.stringifyで引用している。JSONの文字列はYAMLとしても読めるので、題名に:や#があっても壊れない。 - 既定の規則は言語を
codeのclassから読むが、このブログではpreのdata-language属性にあるので規則を足している。
	service.addRule('fencedCodeWithLanguage', {
		filter: (node) => node.nodeName === 'PRE' && node.firstChild?.nodeName === 'CODE',
		replacement: (_content, node) => {
			const code = (node.firstChild?.textContent ?? '').replace(/\n$/u, '')
			const fence = fenceFor(code)
			const language = toFenceLanguage(node.getAttribute('data-language'))
			return `\n\n${fence}${language}\n${code}\n${fence}\n\n`
		},
})fenceForは、コードの中で続くバッククォートより長いfenceを返す関数です。CSSやMarkdownのコードの中に3つのバッククォートがあっても、そこでコードブロックが閉じません。
HTMLのページの<head>には、Markdown版を指す<link>を出します。
{markdownHref && <link rel="alternate" type="text/markdown" href={markdownHref} />}もっとも、これらの対応を手打ちするのは時代にそぐわないということで、AIに実装依頼を出すのがいいでしょう。以下のプロンプトは実際に使った指示を元に、短くしたものです。
トップ、記事、記事の一覧、About に Markdown 版を作って。
- 出力先は、HTML のページと同じディレクトリの index.md
- 記事の本文は、RSS の全文と同じ経路で描いた HTML を Markdown に変換する。コードブロックは言語付きの fence、表は GFM の表にする
- 先頭に frontmatter を置く。項目は title、description、canonical。日付を取得できるページには last-updated も出す。記事は published、category、tags も
- HTML のページの head に、Markdown 版を指す <link rel="alternate" type="text/markdown"> を出す
- 足す依存は最小限にして、足す前に相談して
Markdownのコンテンツネゴシエーション
Markdown版を作っただけでは、3つのチェッカーに共通していた不合格は消えません。チェッカーが求めているのは、ページと同じURLにAccept: text/markdownを付けて要求したときにMarkdownが返ることです。サーバーが要求のヘッダーを見て返す表現を選ぶこの方式は、RFC 9110(新しいタブで開く)の12.1節でProactive Negotiationと呼ばれています。
Cloudflareには、Accept: text/markdownの要求に対してHTMLをMarkdownに変換して返すMarkdown for Agents(新しいタブで開く)という機能があります。使えるのはPro以上のプランとSSL for SaaSの顧客です。このブログは、ビルドで作ったMarkdown版をWorkerで返しています。
Workerでの振り分け
作業の前はWorkerのスクリプトがなく、静的アセットだけを配っていました。そこに何もimportしない1ファイルのWorkerを足しました。wrangler.jsoncでmainにWorkerのファイルを、assets.bindingにWorkerからアセットを取り出すための名前を書き、run_worker_firstでWorkerを先に通すURLを決めます。
{
	// …
	"main": "./src/worker/index.ts",
	"assets": {
		"directory": "./dist",
		"binding": "ASSETS",
		"html_handling": "auto-trailing-slash",
		"not_found_handling": "404-page",
		// Worker を通した要求は Workers の要求数(無料枠は 1 日 10 万件)に数えられ、アセットだけの要求は数えられない。
		// ページの URL だけを Worker に通し、ページが読み込むファイルと検索インデックスは通さない。`!` の行が優先される
		// …
		"run_worker_first": [
			"/*",
			"!/_astro/*",
			"!/pagefind/*",
			"!/og/*",
			// …
		],
	},
	// …
}Workerは、Markdown版のあるページのパスかどうかと、Acceptがtext/markdownを受け付けるかを見ます。q=0はRFC 9110の12.4.2節(新しいタブで開く)で「受け付けない」の意味なので、除いています。
export const markdownPathFor = (pathname: string): string | null =>
	/^\/(?:about\/|articles\/|article\/[^/]+\/)?$/u.test(pathname) ? `${pathname}index.md` : null

/** Accept が text/markdown を受け付けるか。q=0 は「受け付けない」の意味なので除く */
export const acceptsMarkdown = (accept: string | null): boolean =>
	(accept ?? '').split(',').some((range) => {
		const [type = '', ...params] = range.split(';').map((part) => part.trim().toLowerCase())
		if (type !== 'text/markdown') return false
		const q = params.find((param) => param.startsWith('q='))
		return q === undefined || Number(q.slice(2)) > 0
})acceptsMarkdownが見るのは、Acceptにtext/markdownがあるかと、そのqが0でないかだけです。text/htmlのqとの大小は比べていないので、Acceptの汎用の解析として使うには足りません。
両方に当たれば、index.mdのアセットをtext/markdown; charset=utf-8で返します。Markdown版のないページ(/contact/など)はHTMLのまま返し、存在しないURLには404のまま短いMarkdownを返します。
const handleRequest = async (request: Request, env: Env): Promise<Response> => {
	if (request.method !== 'GET' && request.method !== 'HEAD') return env.ASSETS.fetch(request)

	const { pathname } = new URL(request.url)
	const markdownPath = markdownPathFor(pathname)
	const wantsMarkdown = acceptsMarkdown(request.headers.get('Accept'))

	if (markdownPath !== null && wantsMarkdown) {
		// 元の要求のヘッダー(If-None-Match など)と method を引き継ぎ、パスだけを index.md に替える
		const markdown = await env.ASSETS.fetch(new Request(new URL(markdownPath, request.url), request))
		if (markdown.status === 200 || markdown.status === 304) {
			return withHeaders(markdown, (headers) => {
				headers.set('Content-Type', MARKDOWN_TYPE)
				addVary(headers)
				headers.set('Link', [...SITE_LINKS, `<${pathname}>; rel="canonical"`].join(', '))
			})
		}
		// …
	}

	const response = await env.ASSETS.fetch(request)

	if (response.status === 404) {
		if (wantsMarkdown) return toNotFoundMarkdown(response, request)
		return withHeaders(response, addVary)
	}

	// …
}
応答のヘッダーと確かめた結果
Vary: Acceptは、Markdown版のあるページの応答と404の応答にHTMLを返すときも付けます。RFC 9111の4.1節(新しいタブで開く)では、保存した応答にVaryがあると、そこに挙げた要求ヘッダーが一致しない限りキャッシュは再検証せずにその応答を使えません。HTMLの応答にVaryがないと、キャッシュがHTMLの応答をAccept: text/markdownの要求にも返してしまうおそれがあります。
ページの応答には、Linkヘッダーでサイトマップ、RSS、llms.txtを示します。Linkヘッダーの書き方はRFC 8288(新しいタブで開く)の3節で決まっています。Markdown版のあるページでHTMLを返すときはMarkdown版も足すので、トップのLinkは次の4つになります。
</sitemap-index.xml>; rel="sitemap"; type="application/xml",
</rss.xml>; rel="alternate"; type="application/rss+xml",
</llms.txt>; rel="describedby"; type="text/plain",
</index.md>; rel="alternate"; type="text/markdown"
404のMarkdownは、「# ページが見つかりません」の見出しと「要求された URL のページはありません。」の1文に、ホーム、記事の一覧、サイトマップ、llms.txtへのリンクを並べたものです。存在しないURLを求めたクライアントも、次に読むページを応答の中から選べます。
index.mdのURLを直接求めた応答には、X-Robots-Tag: noindexと、HTMLのページを指すLink: <…>; rel="canonical"を付けます。Markdown版はHTMLのページの写しなので、検索に出すのはHTMLのページだけにするためです。
本番で確かめた応答は次のとおりです。Markdown版のない/contact/は、Accept: text/markdownを付けて要求してもHTMLのまま返りました。
| 要求 | 状態 | 主なヘッダーと本文 |
|---|---|---|
GET /(Accept: text/markdown) | 200 | Content-Type: text/markdown; charset=utf-8、Vary: Accept |
GET /(Accept: text/html) | 200 | Content-Type: text/html、Vary: Accept、Linkに4つ |
GET /nope-xyz(Accept: text/markdown) | 404 | Content-Type: text/markdown; charset=utf-8。本文は「# ページが見つかりません」とリンク4つ |
GET /index.md | 200 | Content-Type: text/markdown; charset=utf-8、Link: </>; rel="canonical"、X-Robots-Tag: noindex |
Cloudflareで注意したこと
注意した点は4つあります。これらはブランチのプレビューか本番の応答で確かめました。
1つめは、public/_headersの規則(CSPやHSTSなど)が、Workerを通した応答に残るかです。Cloudflareの文書(新しいタブで開く)にあるのは「Workerのコードが作った応答には当たらない」までで、env.ASSETS.fetch()で取ったアセットの応答については明記がありませんでした。プレビューで確かめると、アセットの応答には_headersが当たっていました。404のMarkdownのようにWorkerが本文を作る応答は、アセットの404の応答からヘッダーを写して作っています。アセットの応答のヘッダーは書き換えられないことがあるので、書き換えるときはnew Response(response.body, response)で作り直します。
const withHeaders = (response: Response, edit: (headers: Headers) => void): Response => {
	const next = new Response(response.body, response)
	edit(next.headers)
	return next
}2つめは、public/_redirectsの転送です。文書(新しいタブで開く)によると、_redirectsの規則はWorkerのコードが処理する要求に当たりません。_redirectsで転送する旧URLは、run_worker_firstの!の行で除外しました。_redirectsに行を足したら、ここにも足す必要があります。
3つめは、Workersの要求数です。静的アセットへの要求は無料で無制限(新しいタブで開く)ですが、Workerを通した要求はWorkersの要求数に数えられます。無料のプランの上限は1日10万件(新しいタブで開く)で、run_worker_firstに当たる要求は、上限を超えるとアセットに切り替わらずにエラーになります。ページが読み込むファイル(/_astro/など)と検索インデックスは、Workerを通さないようにしました。
4つめは、手元の確かめ方です。astro previewとブラウザのテストはWorkerを通りません。振り分けは偽のアセットを渡す単体テストで確かめ、実際の応答はブランチのプレビュー(*.workers.dev)で確かめました。
AIに頼むときのプロンプト例は次の形です。実際に使った指示を元に短くしたものです。
Accept: text/markdown の要求に、同じ URL で Markdown 版を返したい。
ホスティングは Cloudflare Workers の静的アセット。
- Markdown 版のあるページは index.md を text/markdown; charset=utf-8 で返す。q=0 は「受け付けない」として扱う
- Markdown 版のないページは HTML のまま返す
- 存在しない URL には、404 のまま、主なページへのリンクを並べた短い Markdown を返す
- Accept で中身が変わる応答には、HTML を返すときも Vary: Accept を付ける
- ページの応答に Link ヘッダーで、サイトマップ、RSS、llms.txt、Markdown 版を示す
- .md を直接求めた応答は、noindex にして、HTML のページを canonical で指す
- Worker を通す要求は最小限にする(ページが読み込むファイルは通さない)
- _headers のセキュリティのヘッダーが Worker を通した応答に残るか、_redirects の転送が効くかを、プレビューの実際の応答で確かめて
- 振り分けは単体テストで確かめて
その他に対応したこと
robots.txtのContent-Signal
robots.txtにContent-Signalの行を足しました。CloudflareのContent Signals(新しいタブで開く)は、取得した内容の使い道についての希望をsearch(検索)、ai-input(AIの回答への入力)、ai-train(AIの学習)の3つで示します。
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=yes
Allow: /

Sitemap: https://www.tak-dcxi.com/sitemap-index.xmlこのブログでは3つともyesにしています。このブログは技術系の記事が多く、読まれて使われるために書いているのでAI学習されることは歓迎しています。取得も止めないので、Allow: /は残しています。行の順は、Cloudflareのブログと文書(新しいタブで開く)の例に合わせました。
注意点としては、Cloudflareのブログにも書かれているとおり、この信号は希望の表明で取得を技術的に防ぐものではありません。また、AI学習されるとマズいプロジェクトではai-trainの値はnoに設定しておく必要があります。
JSON-LD
JSON-LDは2か所を直しました。どちらもチェッカーの判定に合わせた直しです。
1つは、Person(新しいタブで開く)にdescriptionを足したことです。Is Agenticが「Personにdescriptionがない」と判定していました。文面はAboutのプロフィール文をそのまま使い、新しい主張は作っていません。
もう1つは、トップの@graphにBlog(新しいタブで開く)を足したことです。トップは最新の記事を並べているので、その中身を構造化データでも示しました。BlogのblogPostには、トップに並べている最新の記事10件をBlogPostingで並べます。各記事の@idは、記事のページのBlogPostingと同じ値にして、同じ記事として結び付けました。
Blogを足したきっかけは、Elementorのチェッカーの「JSON-LD types」の判定でした。しかし、BlogとBlogPostingを足した後に測り直したものの、この判定(No extended schema types found)は変わっていません。チェッカーが何を拡張の型と数えるかは、判定の文面からは分かりませんでした。
プライバシーポリシーのページ
/privacy/を足しました。Is Agenticの「Trust anchor pages」の項目が、AboutとContactはあるもののPrivacyがない、と判定していたためです。この項目は500文字以上のページを求めますが、これはIs Agenticの判定の条件です。
文面は、サイトが訪問者から集めているものと送り先を、コードと本番の通信から洗い出すところから作りました。お問い合わせのフォームやアクセス解析はすぐに挙がりますが、漏れやすいのは記事の中です。このブログでは、記事の実装例が外部(picsum.photosやjsDelivrなど)から画像やCSSを読み込んでいて、最初の文面にはそれが入っていませんでした。AIによるレビューで指摘されて、1文足しています。
ページを足した後のIs Agenticでは、Recommendedの検査が6件すべて通りました。
進め方
作業はClaude Codeで進めました。最初に3つのチェッカーの結果を貼り、対応する範囲を質問で詰めてから始めています。
チェッカーには、直すためのプロンプトを出すものもあります(Is Agenticの「Prompt to improve」など)。これはそのまま実行させず、項目ごとに「このブログに実体があるか」を判断する材料にしました。
このサイトを AI エージェントが読みやすい形にしたい。
下に 3 つのチェッカーの結果を貼る。

(チェッカーの結果を貼る)

- 実体のあるものだけ対応して。このサイトにない機能(API、認証、MCP サーバーなど)のために、形だけのファイルは置かない
- 不合格の項目ごとに、このサイトに実体があるかを判断して、対応する、しないの案を表にして
- 判断に迷う項目と、私の方針が要る項目(AI の学習に使ってよいか、など)は、始める前に質問して
- 範囲が決まったら、項目ごとに PR を分けて進めて
範囲が決まった後は、Claude Codeのサブエージェントに役割を分けました。
| 役割 | モデル(effort) | 仕事 |
|---|---|---|
| 調整役(メインのセッション) | Fable 5.2(medium) | 計画、作る係への指示、差分の確認、コミット |
| 作る係 | Opus 5.5(medium) | コードとテストを書く |
| レビュー係 | Fable 5.2(high) | ブランチの差分全体を、書いた側の会話を持たずに読み、承認か修正かを判定する |
調整役とレビューにはFable、実装はOpusという形でコストを調整しています。
PRを出す前には、検証のスクリプトが通った記録とレビュー係の承認があるかをClaude Codeのhookが確かめます。
まとめ
個人のブログをAgent Readyにするうえで私が中心に置いたのは、ページのMarkdown版と、それを同じURLで返すコンテンツネゴシエーションです。Markdown版はビルドで作り、WorkerはAcceptを見てindex.mdを返すだけなので、静的サイトのままでも組めます。
Markdown版は見つけてもらえなければ読まれません。そのための仕組みが、サイトの案内と記事の一覧を載せたllms.txtとページの応答からMarkdown版やllms.txtを指すLinkヘッダーです。使ってよい範囲はrobots.txtのContent-Signalで示しました。どれも、Astroの静的サイトとCloudflare Workersの静的アセットという構成を変えずに入れられます。